Amazon Redshift
这款云数据仓库在分析和代理式人工智能方面提供卓越的性价比
为什么选择 Amazon Redshift?
Amazon Redshift 基于云经济模式构建,可根据您的使用量扩展——能够在您的数据仓库上运行现代分析和自主的代理式人工智能工作负载。跨数据仓库和数据湖中的数据提出任何问题。查询 Apache Iceberg 等开放表格式。与其它云数据仓库相比,仪表板中的新查询性价比最高可提升 8.3 倍,吞吐量最高可提升 7 倍。搭载 Graviton 芯片的新型 RG 实例运行工作负载的速度比上一代 RA3 快 2.4 倍,且每 vCPU 价格降低 30%;该实例专为满足分析和人工智能代理中的查询量与延迟需求而构建。使用 Redshift Serverless,无需管理基础设施,即可在数秒内将数据转化为见解。在 Amazon SageMaker 中跨湖仓支持 SQL 分析,为您提供一个统一环境,以便跨数据仓库和数据湖进行查询、分析和构建。
优势
在 Redshift 中扩展数据分析工作负载时,仪表板中的新查询性价比最高可提升 8.3 倍,吞吐量比其他云数据仓库高出 7 倍。通过在整个组织中使用可扩展的多数据仓库架构隔离工作负载,降低成本并满足业务关键型 SLA。借助网络隔离等全面的安全功能和精细访问控制(例如行级和列级权限),您可以保护数据,而无需支付额外费用。
通过与 Amazon SageMaker 的无缝集成,在所有统一数据中使用 Redshift 强大的 SQL 分析功能。高性能地查询存储在 Amazon S3 上、采用开放格式的数据,无需在数据湖和数据仓库之间移动或复制数据。您可以轻松地将 Redshift 数据纳入 SageMaker 湖仓,从而让各种与 AWS 和 Apache Iceberg 兼容的分析引擎及机器学习工具都能访问这些数据。
-
无需构建和管理复杂的管道,即可提供 PB 级数据用于分析,以加快创新,从而实现对分析使用案例的近实时访问。利用零 ETL 集成,在不影响性能的情况下将交易数据从 Amazon Aurora、RDS 和 DynamoDB 等数据库无缝迁移到 Redshift。通过原生流媒体服务集成,从 Amazon Kinesis 和 Amazon MSK 提取大量实时数据。将所有数据集中在一处,启用近实时分析,并直接在 Redshift 中构建预测性机器学习模型,以获得强大的业务见解。
-
使用 Amazon Redshift Serverless,只需几秒即可开始分析您的数据。Redshift Serverless 可从您的工作负载中学习并自动扩展计算,以满足您不断变化的分析需求,因此您无需管理基础设施即可专注于发现见解。简便连接到您的数据来源,并开始分析数据,无需设置或维护基础设施。
-
通过 Redshift 与 Amazon Bedrock 的无缝集成,使用 PB 级组织数据构建个性化应用程序。借助 Redshift 查询编辑器中的 Amazon Q 生成式 SQL,确保数据用户使用自然语言更简便快捷地编写 SQL 查询,从而提高工作效率。调用 Amazon Bedrock 和 SageMaker 的大型语言模型,以执行高级自然语言处理任务,例如文本摘要、实体提取和情绪分析,从而使用 SQL 从数据中获得更深入的见解。
功能聚焦
搭载 AWS Graviton 芯片:速度最高提升 2.4 倍,价格降低 30%
由 AWS Graviton 处理器提供支持的 Amazon Redshift RG 实例性能更佳:运行数据仓库和数据湖工作负载的速度最高可达上一代 RA3 实例的 2.4 倍,且每 vCPU 成本降低 30%。借助内置的数据湖查询引擎,Redshift RG 实例可原生处理开放格式数据(包括 Apache Iceberg 和 Apache Parquet)。速度、成本效益与集成式数据湖查询引擎的结合,使 Redshift RG 能够满足现代分析和代理式人工智能工作负载对查询量及延迟的要求。
对 Apache Iceberg v3 表的读写访问权限
Amazon Redshift 现在提供对数据湖中的 Apache Iceberg v3 表的读写访问权限,并支持默认列值、行血统和删除向量。默认值可简化架构演进;行血统支持仅处理已修改行的增量管道和 CDC 管道;删除向量则可加速高频更新工作负载的读写操作。您可以直接创建 Iceberg v3 表,也可以就地升级现有的 Iceberg v2 表。
新查询性能最高提升 7 倍
Amazon Redshift 从首次运行时起就大幅提升低延迟 SQL 查询的查询响应速度,这些查询适用于近实时分析应用、商业智能仪表板、ETL 管道以及自主式、目标导向型的人工智能代理等场景。增强型代码生成能够生成高度优化且特定于查询的编译代码,从而确保查询启动迅速并且保持高效运行。
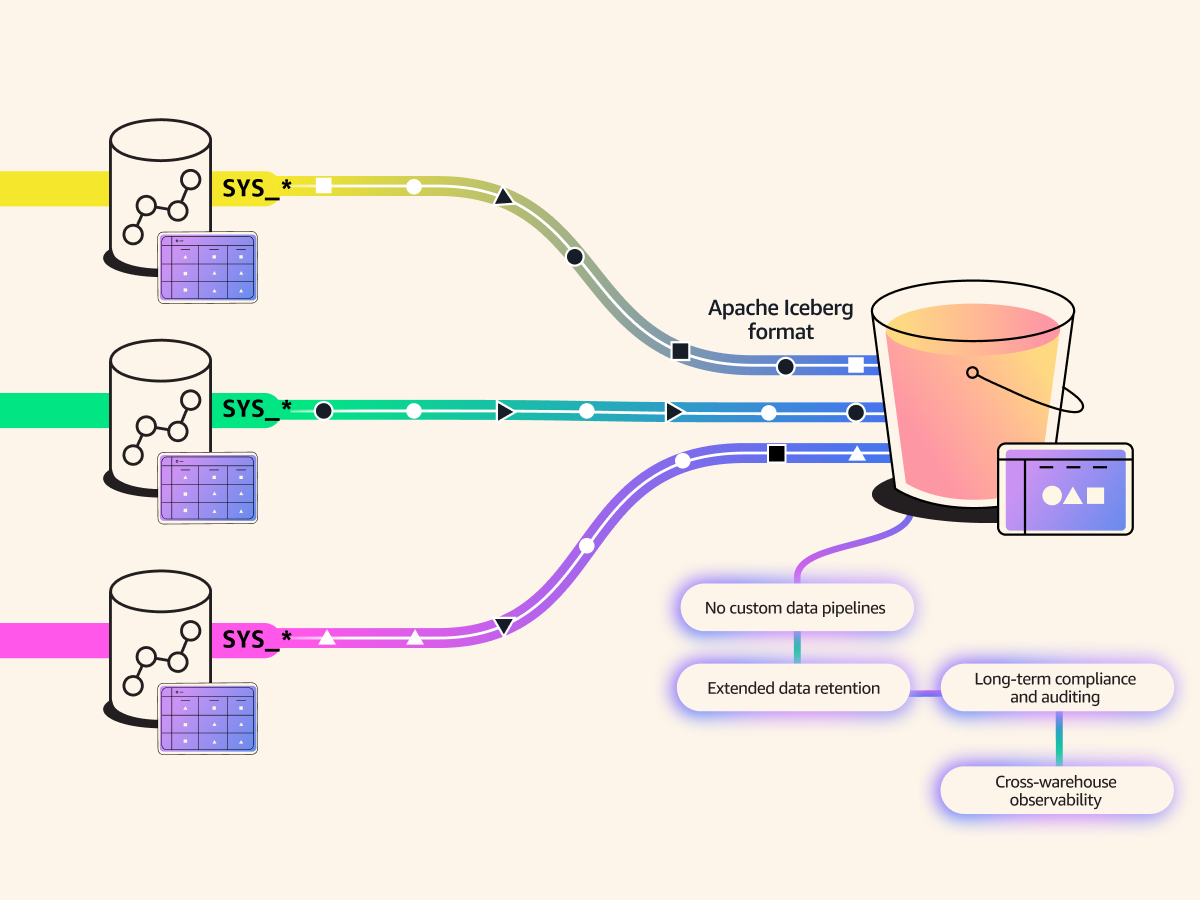
通过集成 Amazon S3 表类数据存储服务延长系统表保留期
您现在可以配置 Redshift 系统表数据的保留期限,使其超过目前的 7 天限制,从而满足合规、审计和可观测性需求。启用该功能后,AWS 会自动以 Apache Iceberg 格式将系统表数据写入 Amazon S3 表类数据存储服务,并负责管理分区、压缩和数据留存。
使用案例
每秒摄取数百兆字节的数据,因此您可以近乎实时地查询数据,并构建用于欺诈检测、实时排行榜和物联网的低延迟分析应用程序。
利用 Amazon Redshift 和 BI 工具(如 Amazon QuickSight、Tableau、Microsoft PowerBI 或其他工具)构建洞察驱动型报告和控制面板。
利用 SQL 为预测分析、分类、回归等多种用例构建、训练和部署机器学习模型,支持对大量数据进行高级分析。
在数据库、数据仓库和数据湖中的所有数据之上构建应用程序。无缝、安全地进行数据共享和协作,为客户创造更多价值,将数据作为服务获利,并开辟新的收入来源。
无论是市场数据、社交媒体分析、天气数据还是其他数据,您都可以订阅 AWS Data Exchange 中的第三方数据并将其与您在 Amazon Redshift 中的数据相结合,而无需费心处理许可和载入流程以及将数据移至仓库。
Amazon Redshift Serverless
在数秒内轻松运行和扩展分析,而无需调配和管理数据仓库
找到今天要查找的内容了吗?
请提供您的意见,以便我们改进网页内容的质量